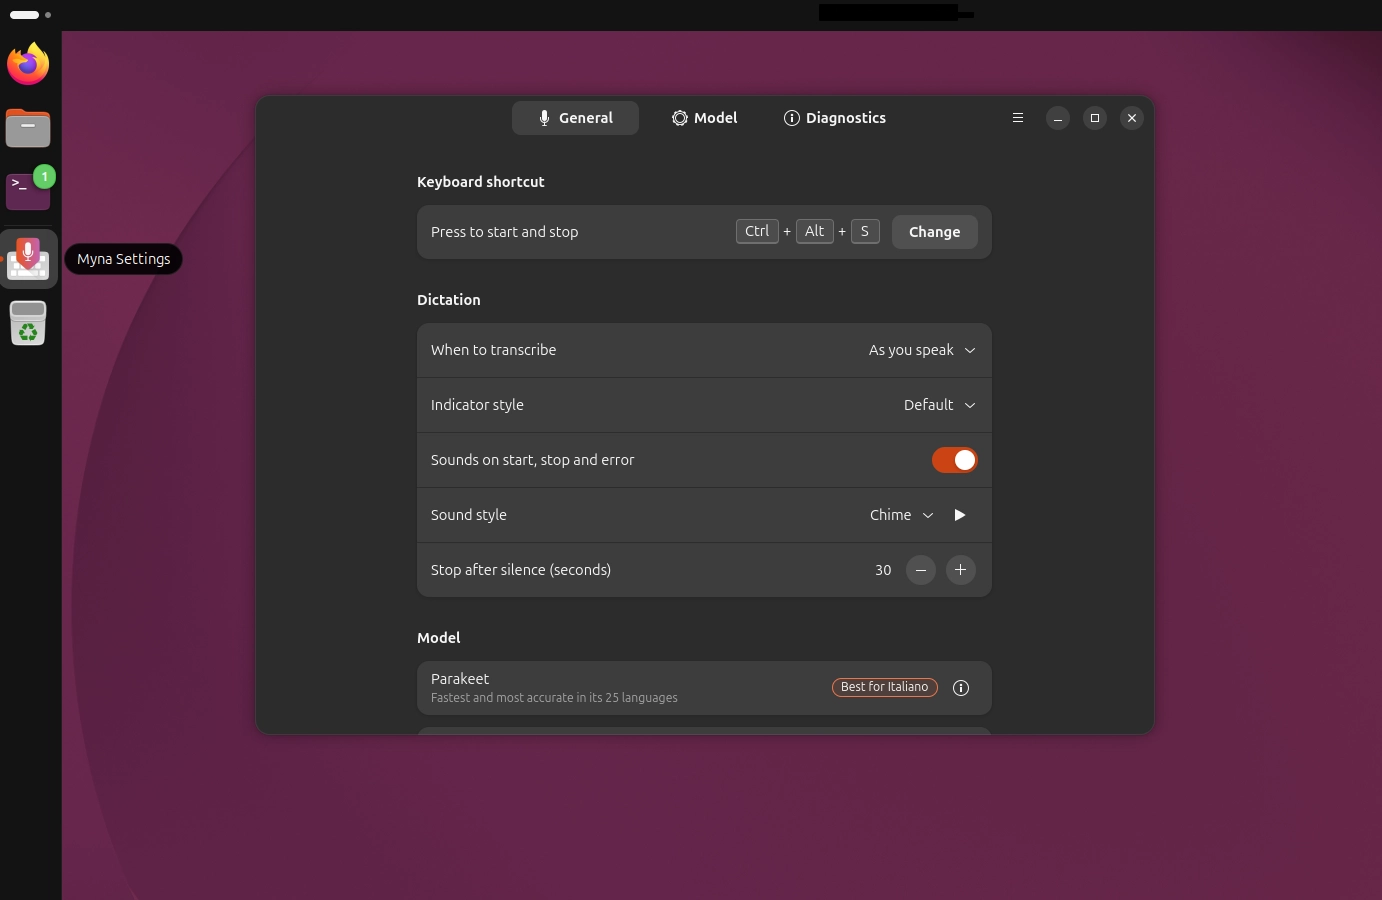
Canonical ha annunciato la disponibilità di Myna in versione Technology Preview, uno strumento di dettatura vocale basato sull’intelligenza artificiale progettato per l’ambiente desktop Ubuntu. Il progetto permette di convertire la voce in testo direttamente sul computer, offrendo un sistema utilizzabile in numerose applicazioni senza dipendere da servizi di riconoscimento vocale online.
Myna rappresenta un’interessante novità per gli utenti Linux che desiderano velocizzare la scrittura di documenti, messaggi ed email, oppure inserire comandi e testo all’interno di un terminale utilizzando semplicemente la voce. L’obiettivo è rendere la dettatura più accessibile e integrata nell’esperienza desktop, senza richiedere applicazioni specifiche per ogni programma.
Uno degli aspetti più interessanti del progetto riguarda la privacy. Il riconoscimento vocale avviene localmente, attraverso modelli di intelligenza artificiale eseguiti sul dispositivo. L’audio viene elaborato in memoria e successivamente eliminato, senza essere archiviato o trasmesso a server esterni per l’elaborazione.
La versione preliminare è disponibile per Ubuntu 24.04 LTS, Ubuntu 26.04 LTS e Ubuntu 26.10, con alcune limitazioni legate alla configurazione del sistema. In particolare, Myna richiede il desktop GNOME predefinito e una sessione Wayland. Non si tratta quindi di una funzionalità universale per tutte le distribuzioni Linux o per qualsiasi ambiente grafico.
Come funziona Myna e quali modelli AI supporta
Myna è stato progettato per offrire un sistema di dettatura utilizzabile in diversi contesti, senza dover copiare manualmente il testo da un’applicazione all’altra. Una volta completata la configurazione, l’utente può attivare il riconoscimento vocale attraverso una scorciatoia da tastiera, parlare e premere nuovamente la combinazione scelta per terminare la registrazione.
Il testo riconosciuto viene inserito nel campo attivo, che può appartenere a un editor di testo, a un browser web o al terminale. Questa modalità di funzionamento rende lo strumento particolarmente interessante per chi scrive frequentemente e desidera ridurre il tempo necessario per inserire grandi quantità di testo.
L’architettura di Myna è suddivisa in diversi componenti distribuiti attraverso il sistema Snap. Il pacchetto principale, chiamato myna, coordina le operazioni di dettatura, mentre myna-config mette a disposizione un’interfaccia grafica per configurare lo strumento. A questi componenti si aggiunge il modello di riconoscimento vocale, necessario per convertire l’audio in testo.
La Technology Preview permette di scegliere fra tre modelli con pesi aperti, sviluppati nell’ambito di progetti differenti:
- NVIDIA Parakeet: un modello di riconoscimento vocale pensato per offrire prestazioni elevate, con requisiti che dipendono dalla variante utilizzata.
- OpenAI Whisper: una famiglia di modelli conosciuta per il supporto a numerose lingue e per la capacità di trascrivere registrazioni vocali.
- Alibaba FunASR: una soluzione dedicata al riconoscimento automatico del parlato, con caratteristiche e prestazioni differenti a seconda del modello selezionato.
La disponibilità di più modelli permette di scegliere la soluzione più adatta al proprio computer e alla lingua utilizzata. Alcune configurazioni possono funzionare sfruttando la CPU, mentre altre possono beneficiare dell’accelerazione GPU. La velocità di trascrizione e il consumo di risorse dipendono quindi dall’hardware, dalle dimensioni del modello e dal tipo di utilizzo.
Privacy, compatibilità e prospettive per Ubuntu
Uno dei punti di forza di Ubuntu Myna è la possibilità di utilizzare la dettatura senza trasferire le registrazioni vocali verso servizi cloud. L’elaborazione locale può risultare particolarmente utile per chi lavora con documenti riservati o preferisce mantenere sul proprio dispositivo i dati prodotti durante l’utilizzo quotidiano del computer.
Il comportamento dello strumento prevede inoltre una protezione contro l’inserimento accidentale del testo. Se il campo di destinazione perde il focus, ad esempio perché l’utente seleziona un’altra finestra, la dettatura in corso viene scartata. In questo modo si riduce il rischio che il contenuto venga inserito involontariamente in un’applicazione diversa da quella desiderata.
È importante ricordare che Myna si trova ancora in una fase iniziale di sviluppo. Canonical invita la comunità a provarlo e a condividere le proprie impressioni, precisando che funzionalità e comportamento possono cambiare nel corso dei prossimi mesi. Anche la disponibilità di ulteriori modelli di riconoscimento vocale potrebbe ampliare le possibilità di configurazione.
Come installare Myna
Tengo a precisare che Myna è ancora in fase di sviluppo, possiamo comunque già testarlo su Ubuntu 24.04 LTS e Ubuntu 26.04 LTS e derivate attraverso PPA dedicati basta digitare da terminale:
sudo add-apt-repository ppa:canonical-desktop-team/myna
sudo apt install myna-config
Per gli utenti italiani, il supporto multilingue rappresenta un elemento da valutare con attenzione. La qualità della trascrizione può variare in base al modello scelto, alla lingua, alla pronuncia e alla presenza di rumori ambientali. Prima di adottare Myna per un utilizzo professionale, è quindi opportuno verificare l’accuratezza nella trascrizione dell’italiano e il comportamento con termini tecnici, nomi propri e punteggiatura.
L’iniziativa mostra inoltre una possibile direzione per l’evoluzione del desktop Linux: integrare funzionalità basate sull’intelligenza artificiale mantenendo l’elaborazione sul dispositivo e offrendo agli utenti un maggiore controllo sui propri dati. Per il momento Myna è uno strumento di dettatura e non un assistente vocale capace di eseguire operazioni tramite comandi conversazionali, ma il suo sviluppo potrebbe contribuire a rendere l’interazione vocale una componente sempre più pratica nell’utilizzo quotidiano di Ubuntu.